关注 SEOWE跨境说
微信扫一扫关注公众号
产品页不断上新,分类页也在调整,XML Sitemap 已经提交到 Google Search Console,但新页面还是迟迟没有进入索引。
打开 GSC,发现一批 URL 停留在“已发现 – 尚未编入索引”(Discovered – currently not indexed)。还有一些页面以前收录过,过一段时间又从索引中消失。
遇到这种情况,很多卖家的第一反应是检查产品描述:是不是内容太少?是不是和其他页面重复?是不是 AI 生成的文案质量不够?
这些因素确实值得检查,但还有一个经常被忽略的问题:Google 能不能通过网站现有的链接结构,顺利找到这些页面?
有些独立站的产品并不少,网站地图也很完整,但重要产品页只出现在多层分类、筛选结果或分页列表中。用户需要反复点击才能找到,搜索引擎也缺少足够清晰的内部链接路径。
这时候,问题就不只是页面写得好不好,而是整个网站有没有把重要页面组织起来。
Crawl Depth(抓取深度)和 Internal Linking(内部链接),正是排查这类问题时值得关注的两个方向。
Crawl Depth 通常用来描述一个页面从网站入口页面出发,需要经过多少次链接点击才能到达。
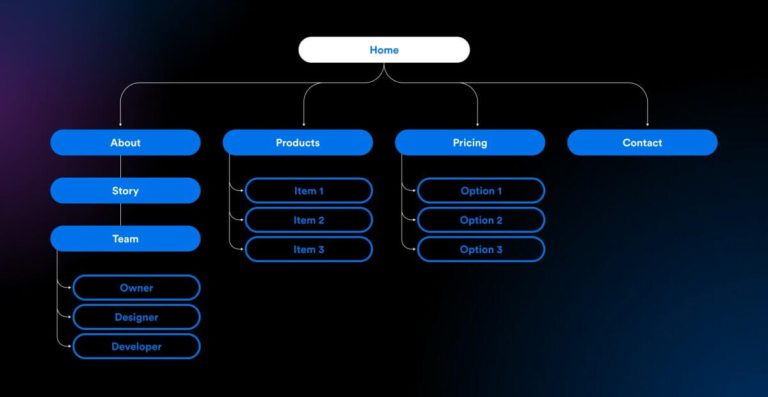
假设一个网站的结构是:
如果从首页进入分类页需要一次点击,再进入子分类、产品列表,最后打开产品详情页,那么这个产品页的点击深度就是 4。
这里需要注意:Crawl Depth 是分析网站链接结构的一种方式,不是 Google 给每个页面设定的官方评分,也不存在所有网站都必须遵守的固定深度标准。
一个产品页需要点击 6 次才能到达,并不意味着 Googlebot 一定无法抓取它;一个页面只需要点击 1 次就能到达,也不代表它一定会被收录。
真正需要关注的是:重要页面是否有清晰、稳定、可抓取的内部链接入口。
例如,一个独立站有 300 个产品,首页只展示几个主推商品,其余产品全部依赖多层分类和分页才能找到。如果部分产品没有出现在任何有效的内部链接中,即使它们已经写进 XML Sitemap,也可能缺少足够清晰的发现路径。
因此,检查 Crawl Depth 的目的不是把所有页面都压缩到两三层,而是找出那些对业务重要、却被埋在网站结构深处的页面。
Crawl Budget(抓取预算)经常被拿来解释页面不收录,但这个概念很容易被过度使用。
Google 对 Crawl Budget 的解释,主要涉及两个方面:
这意味着,抓取预算并不是 Google 每天固定分配给每个网站的一个页面数量。它也不是一个可以通过降低点击深度,就直接增加的额度。
Google 官方的 Crawl Budget 文档,主要面向页面规模非常大、更新频繁的网站。例如,百万级独立页面的网站,或者拥有上万页面且每天频繁更新的网站。
对于只有几百个产品的普通 Shopify 或 WooCommerce 独立站,通常没有必要一上来就把 Crawl Budget 当作核心问题。
更值得先检查的是:
如果网站有大量无意义 URL、重复页面和失效链接,确实可能降低 Google 抓取资源的利用效率。
但不要看到“已发现 – 尚未编入索引”,就直接认定是 Crawl Budget 不够。
XML Sitemap 的作用,是向搜索引擎提供网站中希望被发现的 URL 清单。
它很有用,但不等于 Google 会按照清单逐个抓取,更不代表提交之后就一定收录。
这里有两个容易混淆的概念:
XML Sitemap:帮助搜索引擎发现 URL。
HTML Sitemap:面向用户展示网站页面或栏目入口,也可以提供额外的内部链接。
对于结构复杂、页面数量较多的网站,HTML Sitemap 可以作为辅助导航方式。但它不是 Google 要求每个独立站必须配置的文件,也不能替代正常的分类导航和正文内链。
普通电商网站更应该先做好以下几件事:
Google Sitemap 单个文件有 50MB(未压缩)和 50,000 个 URL 的限制。超过限制时,可以拆分多个 Sitemap,再通过 Sitemap Index 管理。
对于几百个产品的独立站,不需要为了 SEO 特意建立复杂的 Sitemap 系统。先保证提交的 URL 准确、有效、持续更新就够了。
内部链接是改善网站可发现性最直接的方式之一。
假设你有一个销售办公家具的独立站,核心产品包括 Standing Desk、Office Chair 和 Monitor Arm。
如果首页只链接到三个大分类,而具体产品全部藏在多层子分类中,那么部分产品就缺少直接的访问入口。
可以从几个位置重新组织链接:
首页:链接到重要的产品分类和业务专题。
首页不需要展示所有产品,但应该让用户和搜索引擎能够顺着清晰的导航进入核心分类。
分类页:链接到相关产品和细分分类。
分类页不只是产品列表,也是网站内部链接结构的重要枢纽。产品数量较多时,可以通过合理的分页和筛选设计,保证产品能够被正常发现。
产品页:链接到相关产品和必要的支持内容。
例如,Standing Desk 产品页可以链接到相关桌架、桌面配件、安装说明和尺寸选择指南。
Blog:将信息型内容与商业页面连接起来。
如果一篇文章讨论如何选择升降桌,就可以在相关位置链接到升降桌分类页或具体产品,而不是只让 Blog 文章之间相互链接。
这里有一个原则:内链应该符合页面之间的真实关系。
不要为了增加链接数量,把所有文章都链接到首页;也不要让每个产品页都机械地链接到几十个无关产品。
一个有意义的链接,应该让用户知道为什么需要点击,以及点击后能获得什么信息。
Nielsen Norman Group 使用过一个概念:Information Scent(信息气味)。
它描述的是用户在点击链接之前,能否根据链接文字和周围内容,判断点击之后会看到什么。
例如:
这不仅关系到链接是否容易被用户理解,也影响网站的信息架构是否清晰。
在独立站中,链接文字、所在位置和上下文应该相互配合。
比如,一篇讨论办公桌尺寸的文章,在介绍桌面宽度时链接到对应产品分类,比在文章末尾突然出现一个“查看更多产品”的链接更自然。
不过,Information Scent 主要是用户体验和信息设计概念。不能据此推断 Google 会直接按照某个链接的用户点击率或停留时间,提高目标页面的抓取频率。
对 SEO 更实际的意义是:让每条内部链接都表达清楚页面之间的关系,同时帮助用户顺利完成下一步浏览。
产品数量增加之后,分类页通常会出现分页和筛选功能。
例如:
/office-chairs/
/office-chairs/?page=2
/office-chairs/?color=black
/office-chairs/?sort=price
这些 URL 看起来都属于同一个分类,但它们对搜索引擎的价值并不相同。
先说分页。
如果一个分类有几百个产品,不能只让第一页显示产品入口,却没有任何可以抓取的链接通往后续页面。
Google 建议分页使用独立 URL,并通过标准的 <a href> 链接连接前后页面。每个分页页面应有自己的 Canonical,而不是全部指向第一页。
另外,Google 已经不再使用 rel="next" 和 rel="prev" 来识别分页关系。真正重要的是分页链接本身能够被正常发现和访问。
再说筛选和排序。
颜色、尺寸、价格、库存状态等筛选条件,可能生成大量参数 URL。
例如,一个分类支持 5 种颜色、4 种尺寸和 3 种排序方式,就可能组合出大量不同 URL。
但这些 URL 并不一定都值得被搜索引擎收录。
可以先把它们分成两类:
不要把所有筛选 URL 都当成独立 SEO 页面,也不要不加判断地全部开放给搜索引擎。
具体使用 Canonical、noindex 或 robots.txt,需要根据 URL 类型和抓取需求制定规则。尤其要注意:如果 robots.txt 已经阻止 Google 抓取某个 URL,Google 就无法读取该页面上的 noindex 或 Canonical 指令。
如果网站已经有几百甚至几千个 URL,单纯依靠后台菜单很难看清整个链接结构。
可以使用 Screaming Frog、Sitebulb 或 PowerMapper 等工具进行网站爬取和结构审计。
建议重点查看:
这里尤其需要注意 Orphan Page。
一个页面即使已经存在于 Sitemap 中,也不代表它有完善的内部链接入口。对于重要产品页,最好能够从分类页、相关内容或其他合理位置找到它。
但也不必要求所有页面都从首页直接到达。对于大型网站,合理的分类层级本身并没有问题。真正需要处理的是重要页面没有入口、链接路径断裂,或者网站产生了大量无意义 URL。
工具负责发现问题,是否应该增加链接、合并页面或调整分类,仍然需要结合业务价值和用户浏览习惯判断。
最后回到最实际的问题:产品页已经提交,为什么还没有被收录?
GSC 中的“已发现 – 尚未编入索引”,表示 Google 已经知道这个 URL,但目前尚未抓取它。
它和“已抓取 – 尚未编入索引”不是一回事。
前者需要重点检查 URL 是否被发现、抓取资源和服务器状态;后者则说明 Google 已经抓取页面,但暂时没有将它纳入索引,需要进一步检查页面价值、重复内容和规范 URL 等问题。
可以按下面的顺序排查:
第一步:使用 URL Inspection 检查单个产品页。
确认 Google 是否知道这个 URL,是否允许抓取,页面有没有正确的 Canonical,以及最近一次抓取发生在什么时候。
第二步:检查内部链接。
从首页、分类页和相关内容出发,确认是否存在指向该产品页的正常 HTML 链接。
第三步:检查服务器和技术状态。
查看页面是否正常返回 200,是否存在 5xx 错误、访问超时、robots.txt 阻止或错误的 noindex 设置。
第四步:检查 URL 是否值得单独收录。
如果产品页与其他页面只有颜色、尺寸或少量描述差异,且没有独立搜索价值,Google 可能会选择其他规范页面,而不是将所有变体都纳入索引。
第五步:结合 Crawl Stats 和服务器日志。
如果网站规模较大,可以通过 GSC 的 Crawl Stats 和服务器日志观察 Googlebot 是否正常访问,以及是否存在大量重复 URL 或服务器响应问题。
不要把“发布后第3天或第7天还没收录”当成固定故障标准。Google 没有承诺普通网站的新页面必须在某个时间内完成抓取或索引。
独立站的收录问题,不能全部归结为内容质量,也不能全部归结为 Crawl Budget。
如果产品页没有清晰的内部链接入口,分类和分页结构混乱,筛选参数不断生成重复 URL,那么即使 Sitemap 提交得再完整,也不代表网站已经具备良好的页面发现机制。
但反过来,点击深度浅、内链数量多,也不意味着页面一定会被收录。
对大多数跨境独立站来说,更合理的优先级是:
网站结构的目标不是让每个页面都离首页最近,而是让每个值得被收录的页面,都有一条清晰、稳定、合理的发现路径。